



Data Pipeline Orchestration là gì? Tự động hóa luồng dữ liệu với BMC Control-M


Một buổi sáng bình thường của đội ngũ dữ liệu thường bắt đầu bằng một câu hỏi quen thuộc: "Tại sao dashboard kinh doanh hôm nay chưa cập nhật số liệu?"
Khi tra soát ngược lại, nguyên nhân có thể chỉ là một tệp giao dịch từ chi nhánh gửi về trễ 15 phút, khiến tác vụ trích xuất dữ liệu chạy trước khi tệp kịp về, kéo theo toàn bộ chuỗi biến đổi phía sau đổ vỡ dây chuyền.
Khi dữ liệu phân tán trên ERP nội bộ, máy chủ on-premises và nhiều đám mây công cộng (AWS, Azure, Google Cloud), việc neo giữ các tác vụ theo mốc giờ ước lượng bộc lộ rủi ro rất lớn. Đó là lý do Data Pipeline Orchestration trở thành tiêu chuẩn vận hành nền tảng cho mọi tổ chức theo đuổi chiến lược DataOps hiện đại.
Data Pipeline Orchestration là gì?
Data Pipeline Orchestration là quy trình điều phối và quản lý tự động toàn bộ vòng đời của dữ liệu khi nó di chuyển qua các hệ thống, ứng dụng và tầng lưu trữ khác nhau.
Khác với việc lập lịch chạy tác vụ đơn lẻ (Job Scheduling), điều phối đường ống dữ liệu tập trung vào việc quản lý logic thực thi theo trình tự, kiểm tra điều kiện phụ thuộc đa chiều và phản hồi linh hoạt theo thời gian thực hoặc sự kiện phát sinh.
So sánh Job Scheduling truyền thống vs. Data Pipeline Orchestration
| Tiêu chí | Job Scheduling truyền thống | Data Pipeline Orchestration (BMC Control-M) |
| Cơ chế kích hoạt | Cố định theo mốc giờ cứng (Time-based). | Linh hoạt theo sự kiện dữ liệu thực tế. |
| Xử lý quan hệ phụ thuộc | Rời rạc từng hệ thống; dễ chạy đè hoặc lỗi khi thiếu file. | Quản lý phụ thuộc xuyên suốt on-premises và multi-cloud; tự động dừng/chuyển nhánh. |
| Kiểm soát chất lượng | Thường bỏ qua; nạp dữ liệu lỗi vào kho phân tích. | Thiết lập rào chắn dữ liệu trước khi nạp kho. |
| Giám sát & Quản trị SLA | Báo lỗi từng job riêng lẻ; mò mẫm log thủ công. | Dự báo trễ SLA toàn chuỗi, cảnh báo sớm trước khi muộn báo cáo. |
Vì sao pipeline dữ liệu phức tạp khi trải dài qua nhiều hệ thống?
Hạ tầng dữ liệu hiện đại của doanh nghiệp hiếm khi nằm gọn trong một hệ thống duy nhất. Một đường ống dữ liệu thông thường phải băng qua nhiều ranh giới công nghệ:
Đa dạng nền tảng lưu trữ và ứng dụng
Dữ liệu bắt nguồn từ hệ thống ERP on-premises (như SAP), hệ thống thanh toán, tệp tin từ đối tác bên ngoài gửi qua FTP, rồi mới đưa lên các đám mây công cộng (AWS, Azure, Google Cloud).
Đan xen công nghệ mới và cũ
Nhiều tổ chức vừa phải duy trì cơ sở dữ liệu quan hệ truyền thống trên máy chủ vật lý, vừa mở rộng Data Lake trên nền tảng Cloud hiện đại.
Phân mảnh công cụ điều hành (Siloed Tools)
Mỗi nền tảng thường có cơ chế lập lịch riêng. Đám mây có scheduler của đám mây, cơ sở dữ liệu có công cụ tự động hóa riêng, khiến người vận hành không có góc nhìn toàn cảnh về lộ trình di chuyển của dòng dữ liệu.
Đọc thêm: Gigamon Deep Observability Pipeline: Hợp nhất và bảo vệ hạ tầng đám mây lai
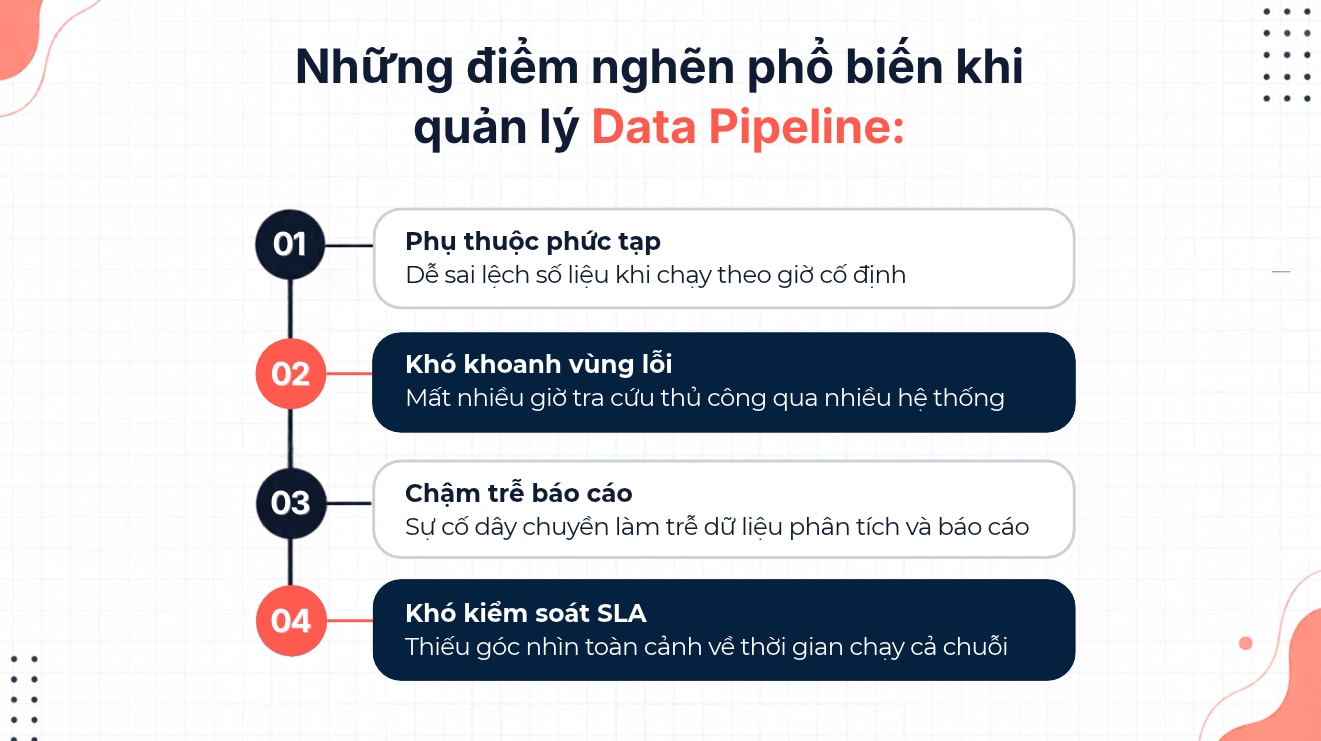
Những điểm nghẽn phổ biến khi quản lý Data Pipeline
Việc thiếu một cơ chế điều phối dữ liệu đa nền tảng thường dẫn đến các thách thức lớn trong vận hành DataOps:
- Mối quan hệ phụ thuộc phức tạp: Một bước tổng hợp số liệu doanh thu chỉ được phép chạy khi toàn bộ tệp chi nhánh đã gửi về và bảng tỷ giá ngoại tệ đã cập nhật. Nếu chỉ chạy theo mốc giờ ước chừng, sai lệch dữ liệu đầu vào sẽ làm sai toàn bộ kết quả phân tích phía sau.
- Lỗi phát sinh không được khoanh vùng: Khi một job ở giữa đường ống bị gián đoạn hoặc định dạng tệp thay đổi, đội ngũ kỹ thuật mất hàng giờ tra cứu thủ công qua từng giao diện để tìm nguyên nhân gốc rễ.
- Báo cáo kinh doanh chậm trễ: Sự cố dây chuyền khiến báo cáo đầu ngày hoặc phân tích thời gian thực không kịp phục vụ lãnh đạo và nghiệp vụ.
- Khó theo dõi và bảo đảm cam kết SLA: Nhà quản trị không nắm được tổng thời gian hoàn thành của toàn chuỗi quy trình, dẫn đến nguy cơ vi phạm cam kết mức độ dịch vụ (SLA) đối với các đơn vị kinh doanh.
Cách BMC Control-M điều phối workflow dữ liệu đầu cuối
Là nền tảng điều phối hàng đầu được tin cậy bởi các tập đoàn lớn toàn cầu, BMC Control-M cung cấp một mặt phẳng điều khiển tập trung giúp thống nhất toàn bộ ứng dụng, dữ liệu và hạ tầng:
- Kết nối luồng dữ liệu đa môi trường: Tích hợp trực tiếp với các dịch vụ đám mây lớn (AWS, Azure, Google Cloud) và các nền tảng dữ liệu phân tích hàng đầu như Databricks, Snowflake, Apache Hadoop mà không đòi hỏi viết mã kết nối phức tạp.
- Tự động hóa theo sự kiện: Kích hoạt tác vụ linh hoạt ngay khi có tín hiệu nghiệp vụ, tệp tin mới xuất hiện hoặc dữ liệu hoàn tất xác thực, thay vì chỉ neo vào mốc giờ cứng nhắc.
- Giám sát SLA thông minh: Sử dụng thuật toán dự báo tiến độ thực thi dựa trên dữ liệu lịch sử, tự động gửi cảnh báo khi phát hiện nguy cơ chậm trễ để kỹ sư chủ động khắc phục trước khi ảnh hưởng đến người dùng cuối.
- Tự xử lý sự cố: Thiết lập quy tắc tự động thử lại, kích hoạt kịch bản khắc phục sự cố hoặc chuyển tiếp dữ liệu dự phòng ngay khi phát sinh lỗi.
Use case minh họa: Từ tiếp nhận dữ liệu đến báo cáo
Giả sử một doanh nghiệp vận hành hệ thống phân tán cần tổng hợp dữ liệu giao dịch và vận hành từ nhiều nguồn (Core, ERP, Cloud) để phát hành báo cáo quản trị đầu ngày. Thay vì để các công cụ tự chạy độc lập theo mốc giờ ước chừng, doanh nghiệp triển khai kiến trúc quản lý Data Pipeline tự động hóa khép kín:
Bước 1: Tiếp nhận dữ liệu đầu vào theo sự kiện
Quy trình tự động hóa luồng dữ liệu bắt đầu khi tệp tin hoặc bản ghi được chuyển từ các chi nhánh/hệ thống nguồn về trung tâm.
- Cơ chế điều phối: Thay vì chỉ lập lịch cố định, Control-M lắng nghe các sự kiện thực tế (như file đã tải xong, tín hiệu API sẵn sàng).
- Kiểm soát phụ thuộc: Nếu dữ liệu nguồn bị trễ hoặc thiếu tệp, hệ thống tự động giữ lại toàn bộ tác vụ phía sau, ngăn chặn hoàn toàn lỗi sập pipeline do thiếu dữ liệu đầu vào.
Bước 2: Xử lý và biến đổi dữ liệu đa nền tảng (Processing & ETL)
Khi dữ liệu đầu vào đạt yêu cầu, Control-M lập tức kích hoạt các tác vụ tính toán chuyên biệt trên từng nền tảng tương ứng.
- Tích hợp linh hoạt: Khởi chạy linh hoạt các job SQL, cụm xử lý Databricks, Spark hoặc một DAG trong Apache Airflow.
- Quản trị tập trung: Các nền tảng chuyên biệt chỉ tập trung xử lý dữ liệu; Control-M đóng vai trò liên kết logic, sử dụng kết quả và mã phản hồi (exit code) của bước trước làm điều kiện kích hoạt bước kế tiếp.
Bước 3: Thiết lập rào chắn kiểm tra chất lượng dữ liệu
Sau khi biến đổi, quy trình kích hoạt các tác vụ kiểm tra chất lượng như đối soát số lượng bản ghi, kiểm tra trường bắt buộc, hoặc xác thực logic tài chính.
- Xử lý ngoại lệ tự động: Control-M đọc trạng thái thực thi của các truy vấn kiểm tra. Nếu dữ liệu không đạt chuẩn (ví dụ: phát hiện dữ liệu rác, chênh lệch số dư), workflow sẽ tự động tạm dừng nhánh công việc phụ thuộc.
- Thông báo tức thì: Hệ thống gửi cảnh báo ngay cho đội ngũ DataOps và chuyển hướng dữ liệu lỗi sang nhánh xử lý ngoại lệ mà không làm tắc nghẽn toàn bộ hệ thống.
Bước 4: Nạp dữ liệu vào kho lưu trữ tập trung (Data Warehouse/Lake Loading)
Dữ liệu sạch sau khi vượt qua bài kiểm tra chất lượng mới được nạp vào kho dữ liệu đám mây (Snowflake, BigQuery, Azure Synapse) hoặc cơ sở dữ liệu phân tích của tổ chức.
- Bảo đảm tính toàn vẹn: Việc điều phối chặt chẽ đảm bảo bước nạp kho chỉ diễn ra khi dữ liệu đã được xử lý và kiểm định 100%, bảo vệ tính chính xác của dữ liệu lịch sử.
Bước 5: Cập nhật báo cáo và chủ động quản trị cam kết SLA
Sau khi kho dữ liệu cập nhật thành công, Control-M gửi lệnh làm mới tập dữ liệu trên các công cụ BI (PowerBI, Tableau).
- Đồng bộ thời gian thực: Báo cáo quản trị chỉ cập nhật khi dữ liệu mới đã sẵn sàng, loại bỏ tình trạng người dùng xem phải báo cáo "rỗng" hoặc số liệu cũ.
- Giám sát SLA dự báo: Control-M liên tục đối chiếu tiến độ chạy thực tế với khung giờ cam kết (ví dụ: báo cáo phải sẵn sàng trước 06:00 sáng). Nếu một tác vụ ở Bước 2 chạy lâu bất thường, hệ thống sẽ cảnh báo sớm nguy cơ trễ SLA để kỹ sư can thiệp trước khi ảnh hưởng đến ban lãnh đạo.
Luồng quy trình minh họa trên cho thấy bản chất của Data Pipeline Orchestration không chỉ đơn thuần là "chạy lệnh tự động". Giá trị lớn nhất nằm ở khả năng kiểm soát điều kiện phụ thuộc đa chiều và khả năng quan sát tập trung, giúp đội ngũ DataOps vận hành các đường ống dữ liệu phức tạp với độ tin cậy và tính chính xác cao nhất.
Lợi ích của Data Pipeline Orchestration đối với DataOps và doanh nghiệp
Triển khai cơ chế điều phối dữ liệu tập trung với BMC Control-M mang lại những giá trị thiết thực:
- Khả năng quan sát toàn diện: Đội ngũ DataOps theo dõi được trạng thái, tiến độ và mối liên kết của tất cả các pipeline trên một giao diện trực quan duy nhất.
- Nâng cao độ tin cậy và chất lượng dữ liệu: Kiểm soát chặt chẽ các bước kiểm tra chất lượng trước khi nạp vào báo cáo, tránh tình trạng "rác vào, rác ra" (Garbage in, Garbage out).
- Phối hợp liên phòng ban nhịp nhàng: Xóa bỏ rào cản giữa đội ngũ phát triển, kỹ sư dữ liệu (DataOps) và khối nghiệp vụ (Business Users), chuẩn hóa quy trình triển khai từ môi trường thử nghiệm sang vận hành thực tế thông qua phương pháp Jobs-as-Code.
- Tối ưu hóa chi phí hạ tầng: Tự động bật/tắt các tài nguyên tính toán trên đám mây chính xác theo thời gian chạy tác vụ, tránh lãng phí chi phí điện toán đám mây.
Khi nào doanh nghiệp nên cân nhắc giải pháp Data Pipeline Orchestration?
Doanh nghiệp có thể cân nhắc một nền tảng điều phối dữ liệu đa nền tảng tập trung nếu đối mặt với một trong các dấu hiệu sau:
- Hạ tầng phân mảnh trên Hybrid & Multi-Cloud: Pipeline dữ liệu trải dài qua nhiều môi trường (từ máy chủ On-premises, cơ sở dữ liệu quan hệ đến Data Lake trên AWS, Azure, Google Cloud), khiến việc quản lý logic phụ thuộc trở nên rối rắm và dễ đứt gãy.
- Tồn tại các bước can thiệp thủ công: Dù có tự động hóa từng phần, các tác vụ phụ thuộc giữa các đội ngũ vẫn cần kỹ sư bấm lệnh thủ công, gửi email kiểm tra hoặc kiểm duyệt trung gian trước khi cho phép bước tiếp theo chạy.
- Mất quá nhiều thời gian tra cứu sự cố: Đội ngũ kỹ thuật phải chuyển đổi qua lại giữa hàng loạt giao diện công cụ khác nhau để mò mẫm tìm nguyên nhân gốc rễ mỗi khi luồng dữ liệu bị lỗi.
- Mất kiểm soát cam kết SLA đầu cuối: Tổ chức chỉ nắm được thời gian chạy của từng job đơn lẻ mà không theo dõi được tổng thời gian hoàn tất của cả quy trình kinh doanh (End-to-End SLA), dẫn đến việc báo cáo đầu ngày liên tục bị chậm trễ.
- Nhu cầu chuẩn hóa thực hành DataOps: Đội ngũ phát triển và vận hành dữ liệu muốn đồng nhất quy chuẩn giám sát, cảnh báo sớm nguy cơ tắc nghẽn và tự động hóa kịch bản khôi phục khi luồng dữ liệu gặp sự cố.
Đọc thêm: Netreo AIOps – Nền tảng giám sát mạng thông minh cho doanh nghiệp hiện đại
Trước khi lựa chọn nền tảng như BMC Control-M, doanh nghiệp nên hoàn thiện bảng rà soát trên để xác định chính xác phạm vi điều phối và các bài toán tích hợp trọng tâm, bảo đảm khoản đầu tư mang lại giá trị vận hành cao nhất.
Lời kết
Khi khối lượng và tốc độ dữ liệu ngày càng gia tăng, doanh nghiệp không thể tiếp tục vận hành các quy trình quan trọng bằng những công cụ lập lịch phân tán. Đầu tư vào Data Pipeline Orchestration với BMC Control-M chính là nền tảng vững chắc giúp tổ chức khai phóng toàn bộ giá trị của dữ liệu và ứng dụng AI vào thực tế kinh doanh.
Nguồn: Control-M Capabilities
Có thể bạn quan tâm

 Loading ...